Whisper 오디오 텍스트 온라인: 브라우저 전사 가이드
Whisper online audio to text 또는 Whisper alternative를 찾는 사용자를 위해 브라우저 전사, 첫 모델 다운로드, TXT/SRT/VTT 내보내기를 설명합니다.
Whisper 전사
Whisper 방식 전사로 편집 가능한 초안 만들기
오디오나 비디오를 업로드하고 Whisper tiny 모델로 전사한 뒤 TXT, SRT, VTT로 저장하세요.
Whisper audio to text가 유용한 경우
Whisper online audio to text를 찾는 이유는 보통 같은 녹음을 반복해서 듣는 시간을 줄이고 싶기 때문입니다. 회의, 인터뷰, 팟캐스트, 강의, 영상 대화를 먼저 편집 가능한 초안으로 만들 때 유용합니다.
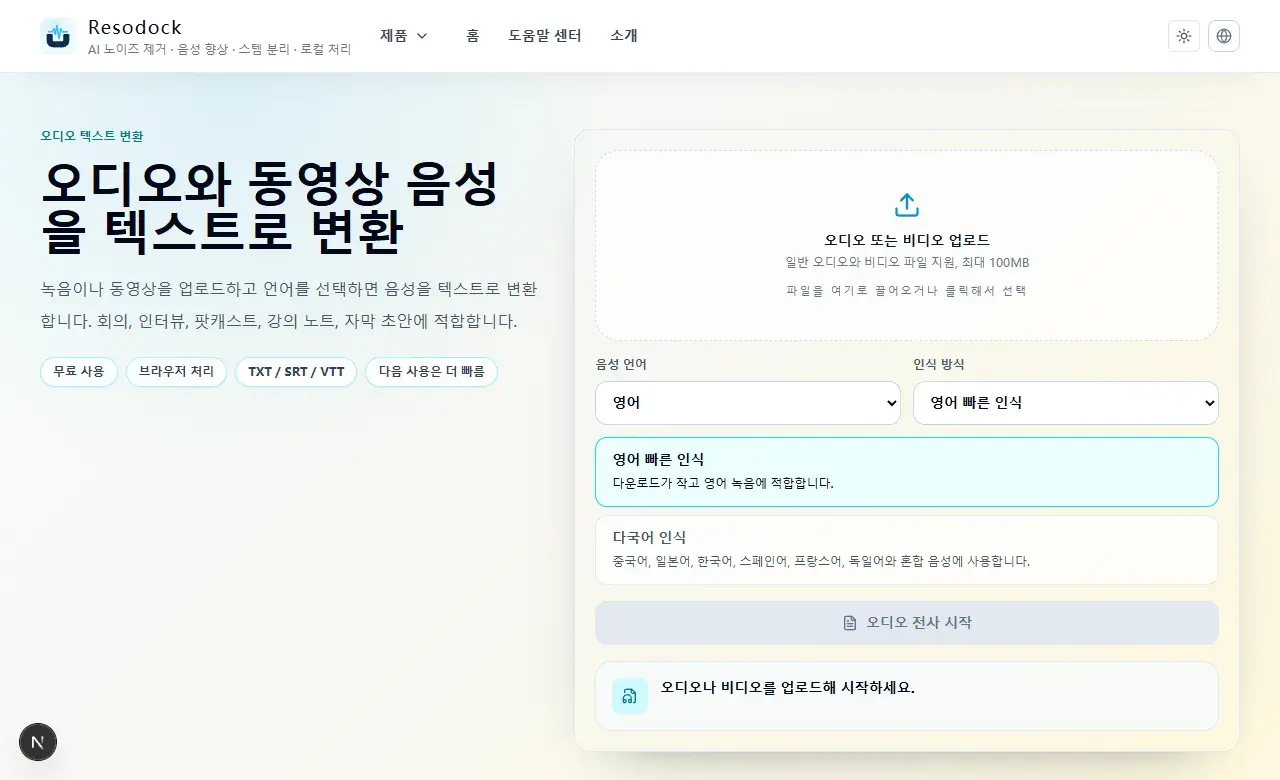
Resodock의 Whisper 오디오 텍스트 페이지에서 오디오나 비디오를 업로드하고 언어를 선택할 수 있습니다. 결과는 복사하거나 TXT, SRT, VTT로 저장할 수 있습니다.
먼저 테스트
Whisper 전사로 짧은 구간부터 확인하세요
Whisper 전사는 짧은 샘플로 먼저 확인하는 것이 좋습니다. 15~30초를 업로드해 언어, 명료도, 첫 모델 로딩을 확인한 뒤 전체 파일을 처리하세요.
- 1Whisper 오디오 텍스트 페이지를 엽니다.
- 2업로드 영역을 클릭하거나 오디오, 비디오 파일을 끌어옵니다.
- 3음성 언어를 선택합니다. 영어 녹음은 영어 빠른 인식을, 다른 언어는 다국어 인식을 사용하세요.
- 4전사를 시작하고 브라우저가 모델을 불러와 텍스트를 만들 때까지 기다립니다.
- 5결과를 확인한 뒤 TXT, SRT, VTT로 저장합니다.
Whisper alternative에서 확인할 점
좋은 Whisper alternative는 모델 이름만 강조하지 않습니다. 언어 선택, 자막 내보내기, 첫 모델 다운로드 설명, 결과 검토의 쉬움이 중요합니다.
브라우저 전사는 시작할 때 인식 파일을 불러올 수 있습니다. 첫 실행은 시간이 걸릴 수 있고, 같은 기기에서는 캐시 덕분에 다음 사용이 더 빨라질 수 있습니다.
Whisper로 오디오를 텍스트로 바꾸는 방법
Whisper 온라인 전사 도구를 열고 MP3, WAV, M4A, FLAC 또는 일반적인 영상 파일을 업로드합니다. 영어 전용 녹음은 영어 빠른 인식을, 한국어와 중국어, 일본어, 스페인어, 프랑스어, 독일어 또는 혼합 언어는 다국어 인식을 선택하세요.
처음부터 1시간 녹음을 처리하지 말고 15~30초를 먼저 테스트하세요. 이름, 숫자, 쉬는 구간, 전문 용어가 읽을 만한지 확인한 뒤 전체 파일을 처리하는 편이 좋습니다.
Whisper 전사 결과가 제한될 수 있는 녹음
Whisper 방식 전사는 말소리가 또렷할수록 안정적입니다. 마이크가 멀거나 배경 음악이 크거나 여러 사람이 겹쳐 말하거나 방 울림과 소음이 크면 오류가 늘 수 있습니다.
녹음에 소음이 많다면 짧은 구간으로 노이즈 제거나 음성 향상을 먼저 테스트하고 결과를 비교하세요. 법률, 의료, 계약, 금융 내용은 초안으로만 보고 반드시 직접 확인해야 합니다.
정리
Whisper audio to text는 녹음을 검색 가능하고 편집 가능하며 내보낼 수 있는 초안으로 만드는 데 좋습니다. 다시 듣는 시간을 줄이고 메모, 글감, 자막 작업을 쉽게 시작할 수 있습니다.
짧은 샘플을 업로드하고 언어를 선택한 뒤 모델 로딩을 기다리고 결과를 확인하세요. 괜찮다면 전체 파일을 처리하고 목적에 맞게 TXT, SRT, VTT로 저장하면 됩니다.
관련 문서
오디오 텍스트 변환
Audio to Text 온라인: 녹음을 텍스트로 바꾸는 쉬운 가이드
audio to text는 녹음을 편집 가능한 초안으로 빠르게 바꿔 줍니다. 짧은 음성으로 먼저 확인하고 TXT, SRT, VTT로 내보내세요.
오디오 텍스트 변환
온라인 오디오 전사: 회의, 인터뷰, 팟캐스트 정리 방법
전체 파일을 바로 전사하지 말고 30초 샘플로 언어와 명료도를 먼저 확인하세요.
오디오 텍스트 변환
회의록을 위한 Audio Transcription AI: 할 수 있는 일과 한계
AI 전사는 회의 초안을 빠르게 만들지만 결정, 할 일, 이름, 숫자, 날짜는 직접 확인해야 합니다.
FAQ
공식 Whisper인가요?
공식 서비스가 아니라 Xenova Whisper tiny 모델을 사용하는 Whisper 방식의 브라우저 전사 페이지입니다.
왜 먼저 모델을 다운로드하나요?
브라우저가 음성을 인식하려면 모델 파일이 필요합니다. 첫 실행은 시간이 걸릴 수 있고 같은 기기에서는 캐시가 도움이 됩니다.
자막으로 내보낼 수 있나요?
가능합니다. SRT와 VTT를 자막 초안으로 저장할 수 있고 TXT도 저장할 수 있습니다.
중국어 오디오도 전사할 수 있나요?
다국어 인식을 선택하고 먼저 15~30초 샘플로 테스트하세요. 이름, 숫자, 날짜, 전문 용어는 직접 확인해야 합니다.